Jun-Hyun Bae, Inchul Choi, Minho Lee
Kyungpook National University
Abstract
Empirical Risk Minimization (ERM) based machine learning algorithms have suffered from weak generalization performance on data obtained from out-of-distribution (OOD). To address this problem, Invariant Risk Minimization (IRM) objective was suggested to find invariant optimal predictor which is less affected by the changes in data distribution. However, even with such progress, IRMv1, the practical formulation of IRM, still shows performance degradation when there are not enough training data, and even fails to generalize to OOD, if the number of spurious correlations is larger than the number of environments. In this paper, to address such problems, we propose a novel meta-learning based approach for IRM. In this method, we do not assume the linearity of classifier for the ease of optimization, and solve ideal bi-level IRM objective with Model-Agnostic Meta-Learning (MAML) framework. Our method is more robust to the data with spurious correlations and can provide an invariant optimal classifier even when data from each distribution are scarce. In experiments, we demonstrate that our algorithm not only has better OOD generalization performance than IRMv1 and all IRM variants, but also addresses the weakness of IRMv1 with improved stability.
Overview
IRMv1에서는 gradient penalty가 작아져도 OoD 성능이 낮을 수 있다. 이 논문은 환경별 데이터가 적거나 여러 spurious feature가 있는 조건에서 그 문제를 살펴보고, IRM의 bi-level 구조를 메타러닝으로 구현한다.
meta-IRM은 한 training environment에서 파라미터를 적응시킨 뒤, 다른 training environment의 손실로 원래 파라미터를 업데이트한다. MAML의 inner/outer loop 사이에서 환경을 바꾸는 구성이다. Colored MNIST에서 두 loop에 같은 환경을 배정한 변형의 OoD 정확도는 13.6%, 서로 다른 환경을 쓰는 전체 방법은 70.4%였다.
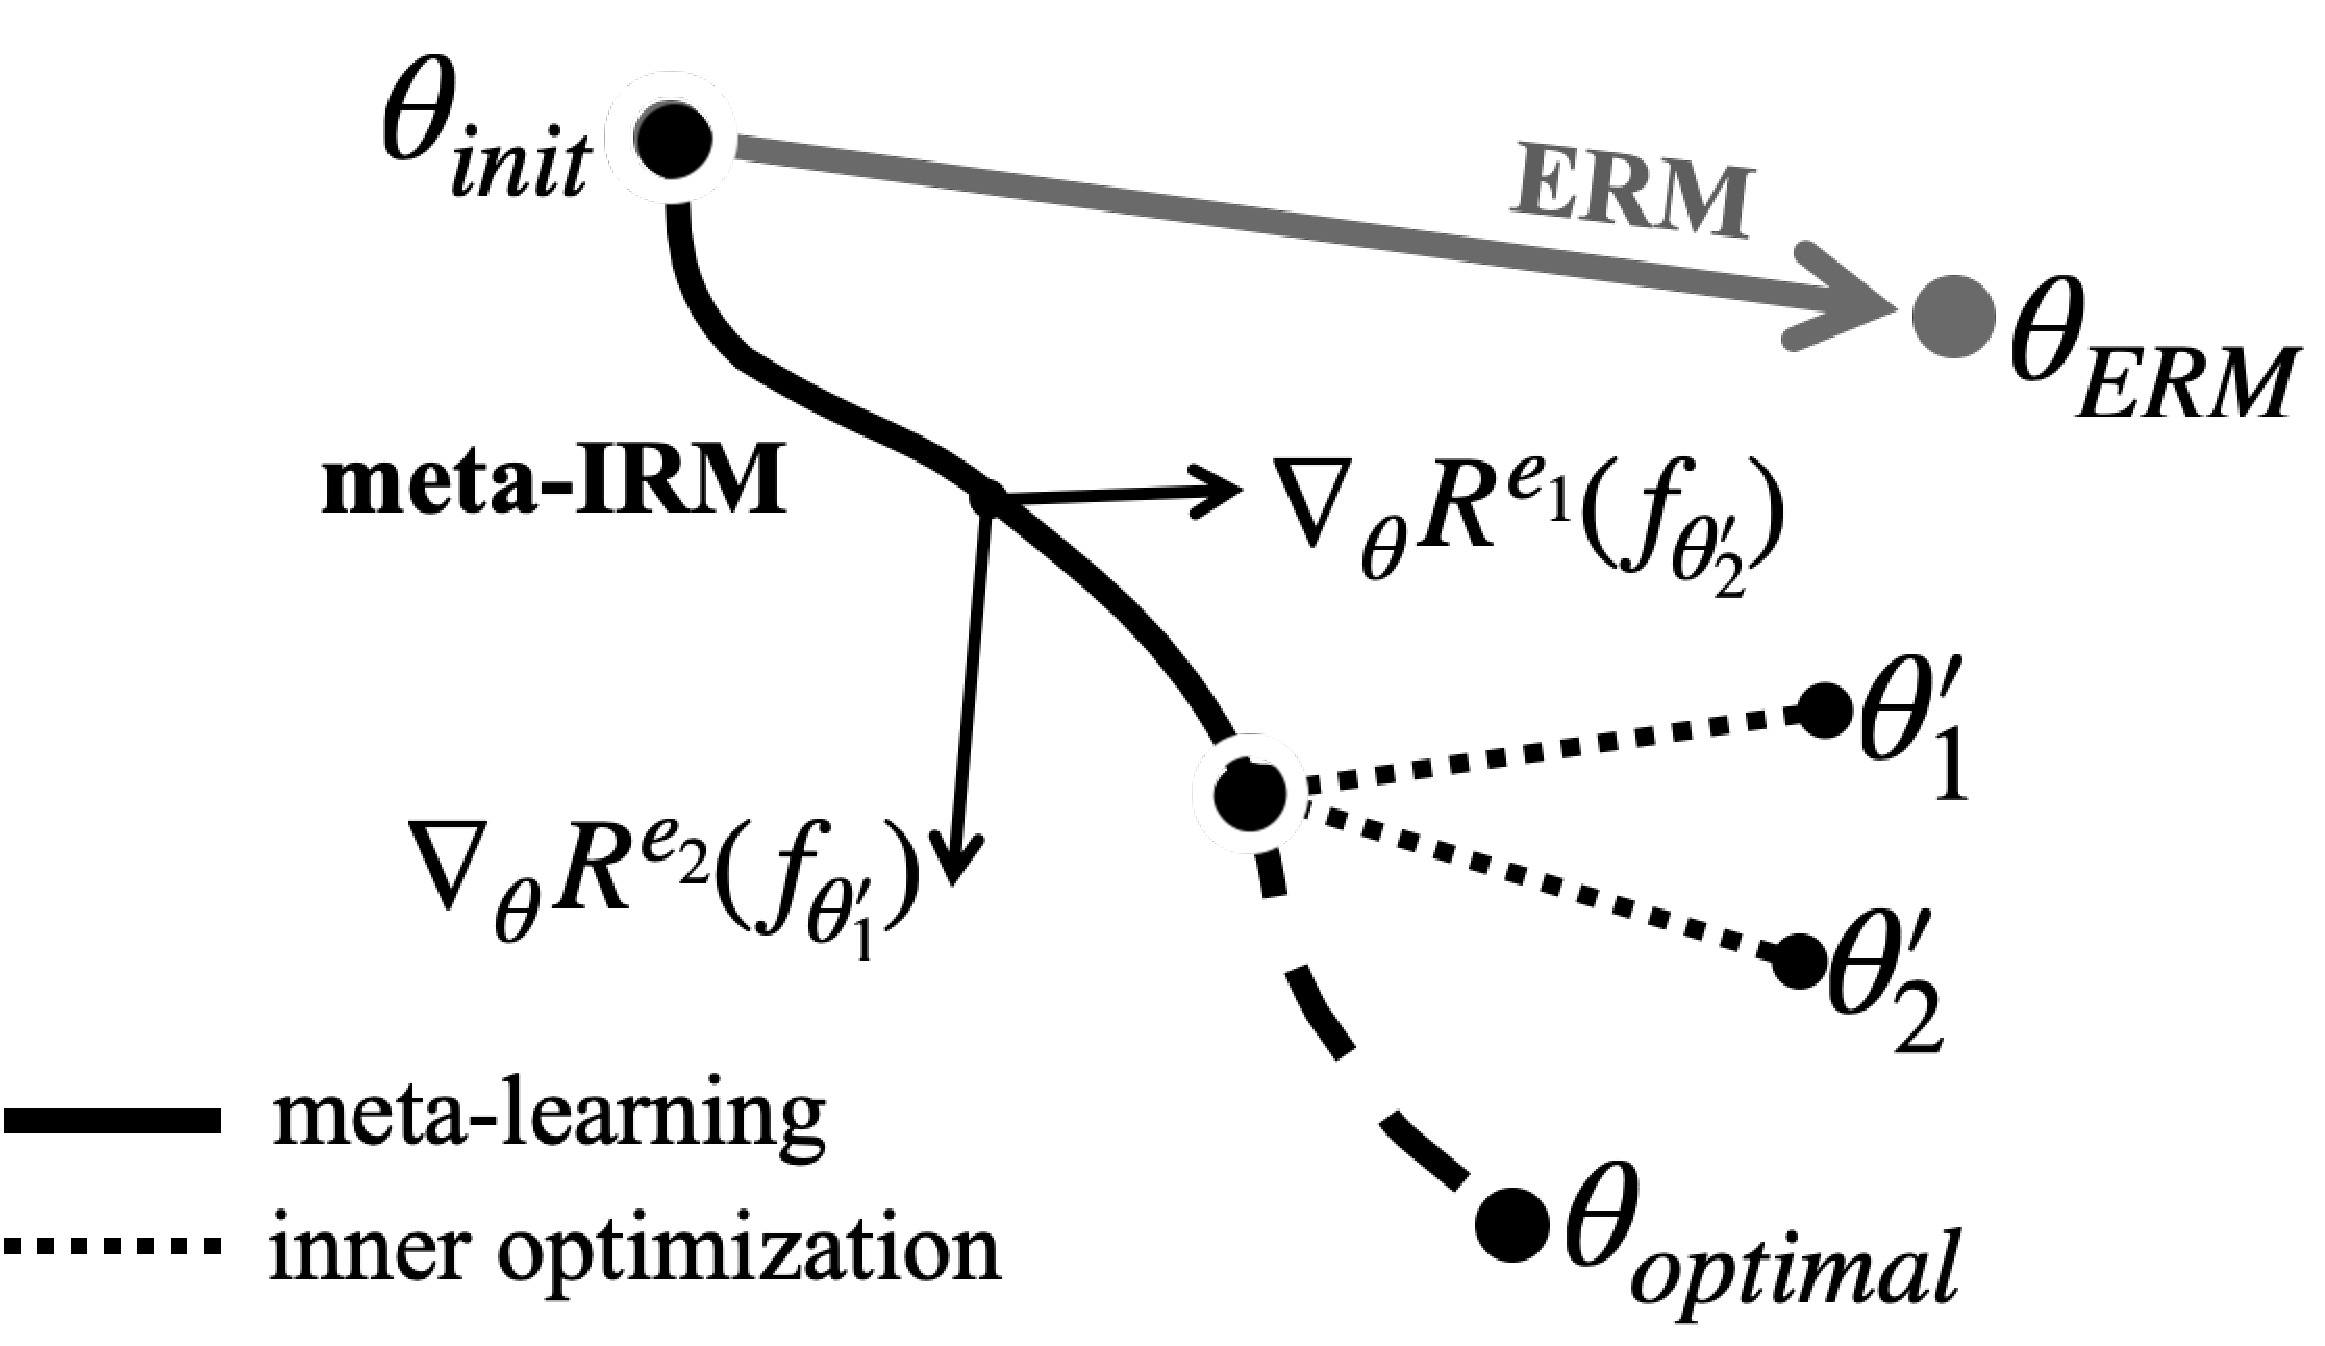
meta-IRM의 학습 아이디어를 나타낸 개념도. 한 environment에 적응한 파라미터($\theta'_1$, $\theta'_2$)를 다른 environment에서 평가하고, 그 gradient를 합쳐 환경에 덜 의존하는 해를 찾도록 유도한다. 그림의 $\theta_{optimal}$은 목표를 나타내며, 모든 조건에서 그 해에 도달한다는 수렴 보장을 뜻하지 않는다.
Method
IRM은 여러 training environment에서 공통으로 최적인 classifier를 사용할 수 있는 표현을 찾는 것이 목표다. 원래 목표에는 환경별 최적화가 제약으로 들어 있어 풀기 어렵다. 실용적인 IRMv1은 classifier를 고정된 스칼라로 두고 이 제약을 gradient penalty로 근사한다. 하지만 데이터가 부족하거나 환경 수에 비해 spurious feature가 많은 조건에서는, penalty가 작아도 OoD 성능이 나쁠 수 있다. 아래의 데이터 감소와 복수 편향 실험이 이런 경우를 살펴본다.
meta-IRM은 IRM의 bi-level 구조를 MAML 기반 학습 절차로 구현한다. 핵심 착안점은 inner loop와 outer loop에 서로 다른 training environment를 배정하는 것이다. 한 환경에 적응한 결과를 다른 환경에서 평가해, 환경을 넘어 유효한 특징을 학습하도록 유도한다. 원래의 제약 최적화 문제를 정확히 풀거나 전역 최적 해로 수렴한다는 보장을 제시하는 것은 아니다.
Meta-Learning Framework
MAML의 inner/outer 구조를 IRM의 bi-level 구조에 대응시킨다. Inner loop는 환경별 적응을, outer loop는 다른 환경까지 고려한 risk 감소를 담당한다. 실제 inner update는 classifier만 고정적으로 골라 갱신하는 것이 아니라 모델 파라미터 \(\theta\)에 적용한다. IRMv1처럼 classifier를 고정된 선형 함수로 제한하지 않는다.
Inner optimization: 각 training environment \(e_i\)에 대해 모델 파라미터를 적응시킨다:
\[\theta_i' = \theta - \alpha \nabla_\theta R^{e_i}(f_\theta)\]Meta-optimization: 적응된 파라미터 \(\theta_i'\)로 다른 environment \(e_j\)에서의 meta-loss를 계산하여 \(\theta\)를 업데이트한다:
\[\theta \leftarrow \theta - \beta \nabla_\theta \left\{ \sum_i \sum_j R^{e_j}(f_{\theta_i'}) + \lambda \sigma \right\}, \quad e_j \sim \mathcal{E}_{tr} \setminus e_i\]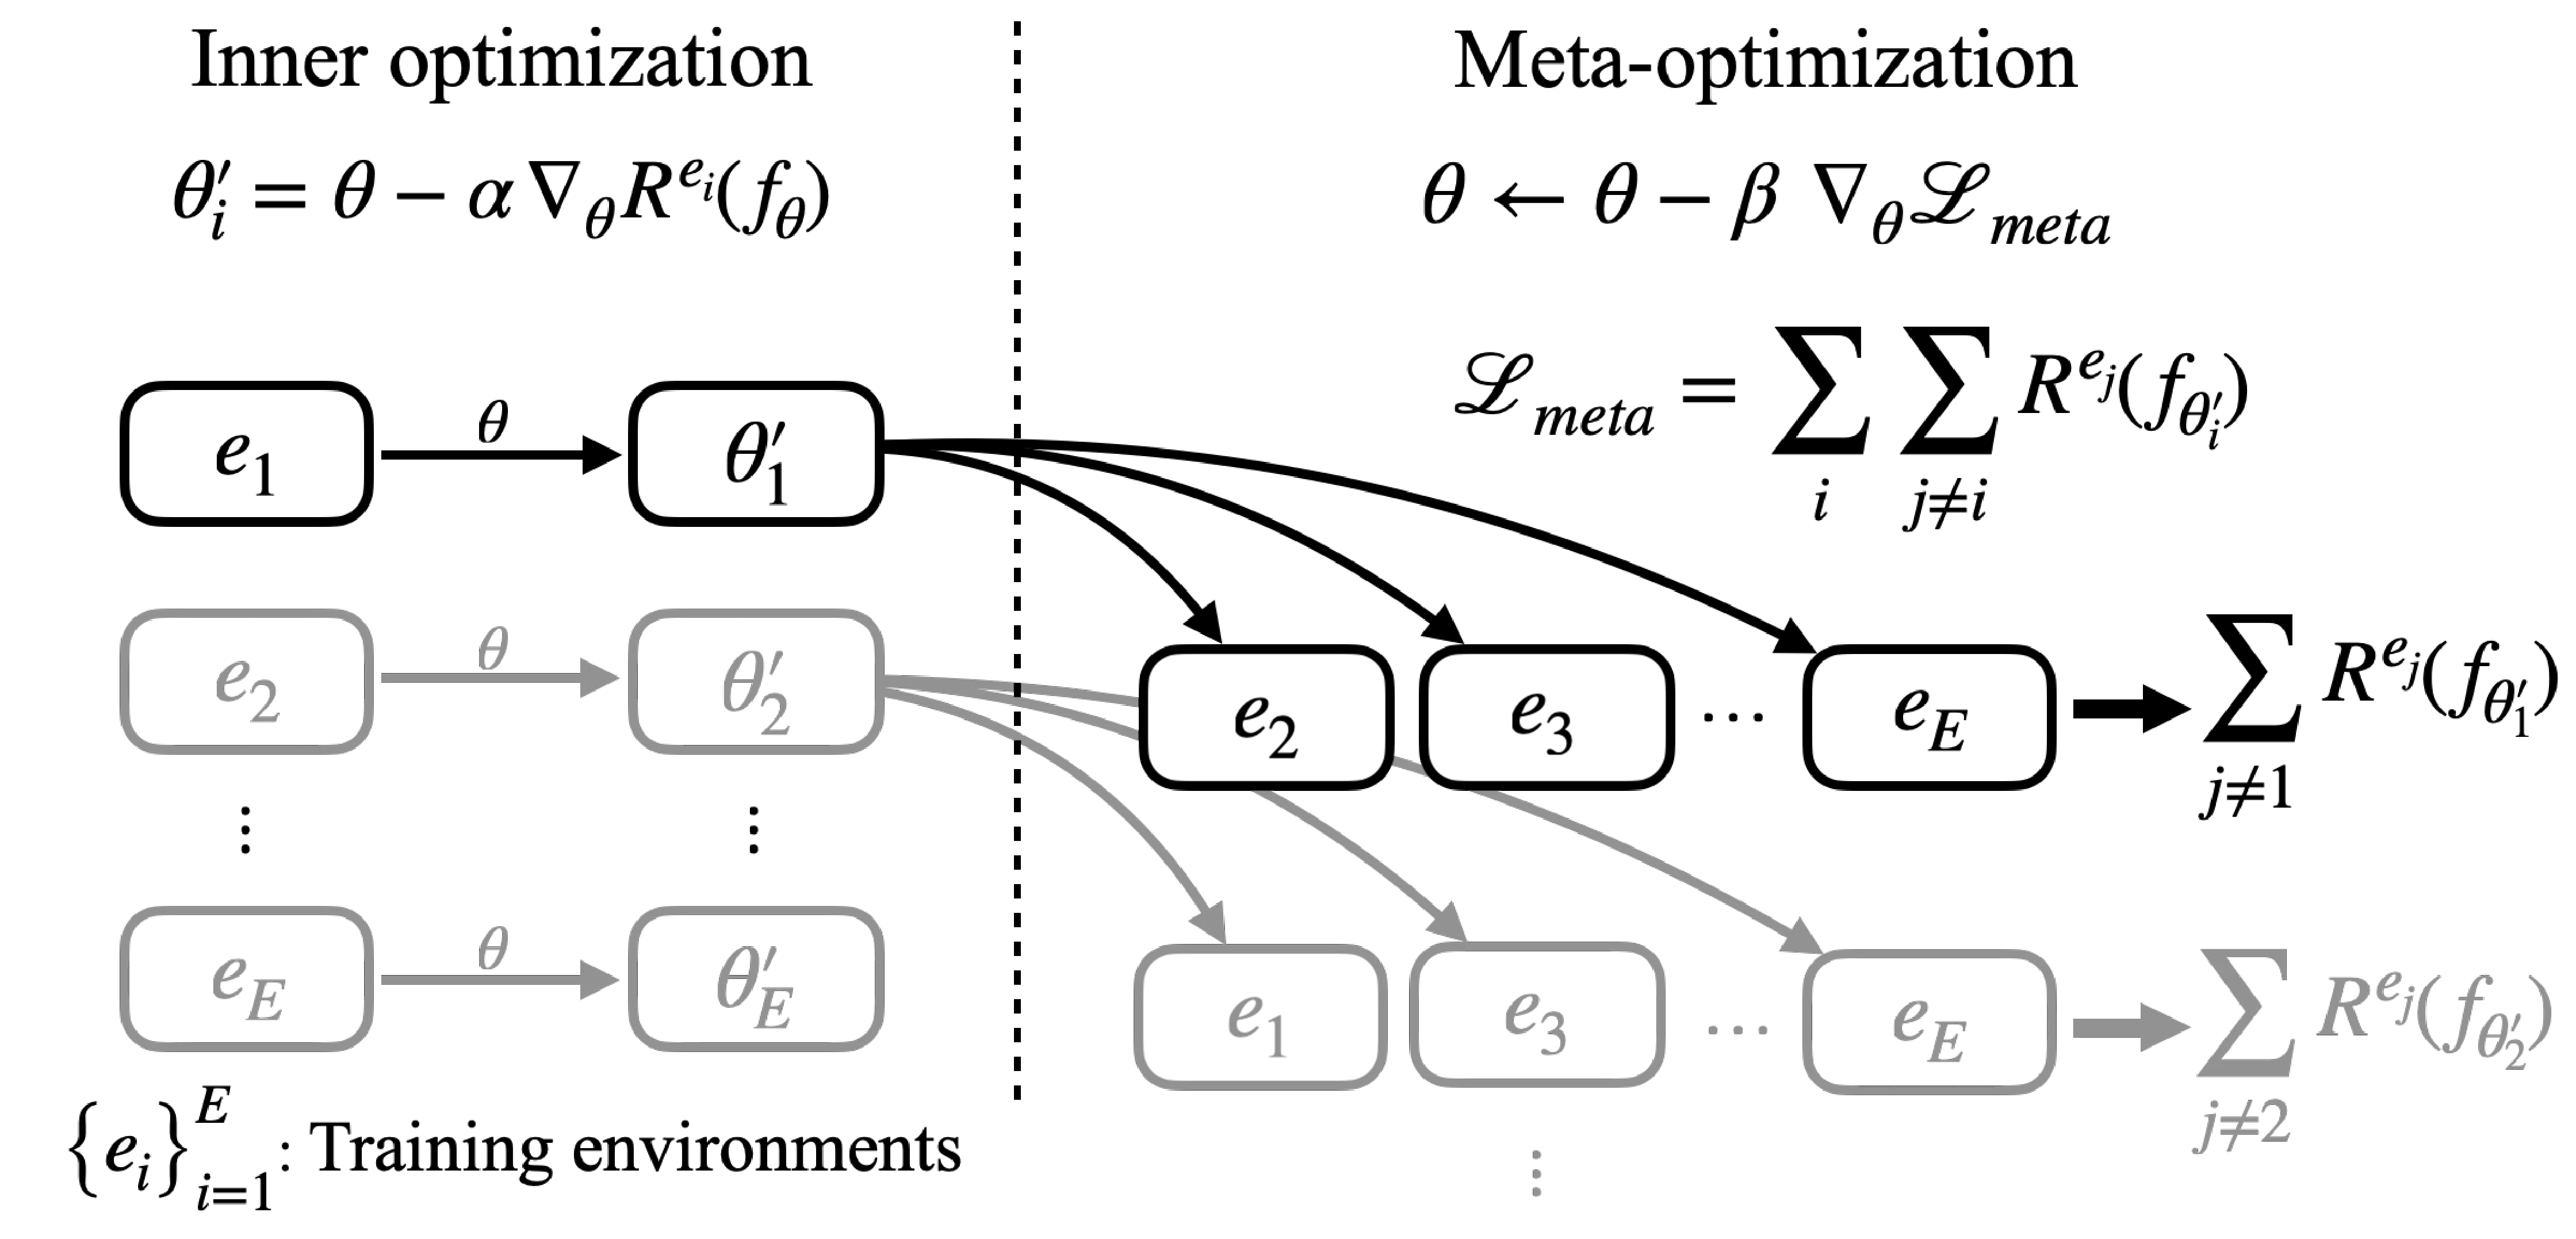
meta-IRM 학습 과정. 모델 파라미터 $\theta$가 inner optimization에서 각 training environment에 적응되고, 적응된 파라미터로 다른 environment에서 meta-loss를 계산한다.
Auxiliary Standard Deviation Loss
Meta-loss의 표준편차 \(\sigma\)를 보조 손실로 추가하여, 모든 environment에서 균일한 성능을 달성하도록 유도한다. 이 정규화는 학습 안정성을 높이고 수렴 속도를 개선한다. \(\lambda\)는 이 보조 손실의 가중치다.
Results
Colored MNIST
숫자 0–4와 5–9를 두 클래스로 나누고, 레이블을 25% 확률로 뒤집어(label noise) 숫자 모양만으로는 75%까지만 맞힐 수 있게 만든다. 색은 레이블을 확률 \(p_e\)로 뒤집어 정하므로, training environment(\(p_e=0.1, 0.2\))에서는 색이 레이블과 각각 90%, 80% 일치하고 test environment(\(p_e=0.9\))에서는 이 관계가 뒤집힌다. 따라서 색에 기대지 않는 이상적인 모델의 정확도는 75%다.
Test accuracy (%) on Colored MNIST. $p_e=0.9$가 OOD 환경 (color-label 상관관계 역전).
| Algorithm | \(p_e=0.1\) | \(p_e=0.2\) | \(p_e=0.9\) (OOD) |
|---|---|---|---|
| ERM | 88.6 ± 0.3 | 79.7 ± 0.6 | 16.4 ± 0.8 |
| IRMv1 | 71.4 ± 0.9 | 70.8 ± 1.0 | 66.9 ± 2.5 |
| MM-REx | 70.8 ± 1.5 | 70.4 ± 2.0 | 66.1 ± 4.9 |
| V-REx | 71.5 ± 0.8 | 71.1 ± 0.9 | 68.6 ± 1.2 |
| meta-IRM (Ours) | 70.9 ± 0.9 | 70.8 ± 1.0 | 70.4 ± 0.9 |
| Random | 50 | 50 | 50 |
| ERM (grayscale) | 72.6 ± 0.3 | 72.7 ± 0.3 | 73.0 ± 0.5 |
| Optimal | 75 | 75 | 75 |
색이 포함된 입력을 받는 비교 방법 중 meta-IRM(70.4%)이 가장 높고, V-REx(68.6%), IRMv1(66.9%), MM-REx(66.1%)보다 실행 간 표준편차도 작다. 색을 미리 제거한 ERM (grayscale)은 별도의 참조값으로 73.0%다. 아래 그림에서 색–레이블 관계를 바꾸어도 meta-IRM의 정확도가 거의 일정한 것은 색에 대한 의존도가 낮다는 해석을 뒷받침한다.
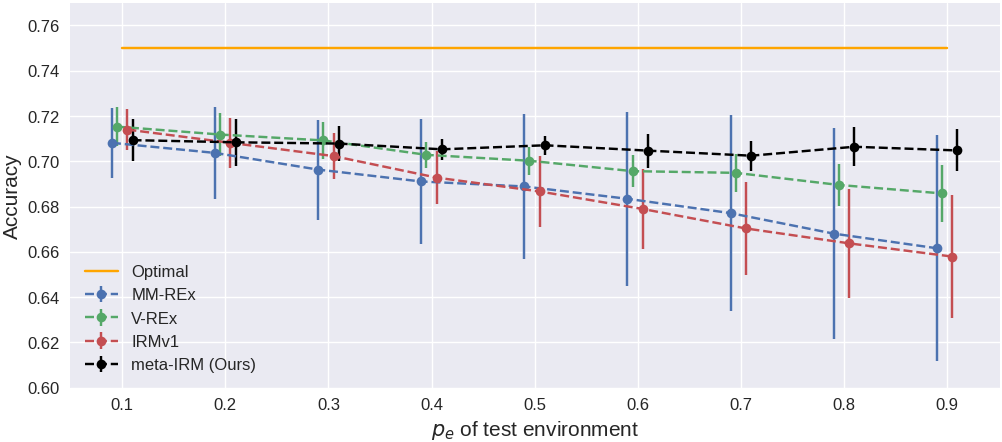
다양한 test environment ($p_e$ 0.1~0.9)에서의 정확도.
Multi-Class Problem
클래스 수가 증가하면 spurious correlation의 구조가 복잡해지며, meta-IRM의 이점이 더욱 두드러진다.
Multi-class Colored MNIST ($k$=5, 10)의 train/test accuracy (%). ERM, IRMv1, ERM (grayscale) 수치는 Choe et al. (2020)에서 인용.
| Algorithm | # Classes | Train | Test (OOD) |
|---|---|---|---|
| ERM | 5 | 95.2 ± 0.2 | 41.0 ± 0.6 |
| IRMv1 | 5 | 82.2 ± 0.4 | 62.0 ± 2.4 |
| meta-IRM (Ours) | 5 | 76.4 ± 1.4 | 74.0 ± 3.6 |
| Random | 5 | 20 | 20 |
| ERM (grayscale) | 5 | 73.2 ± 0.2 | 71.7 ± 0.4 |
| ERM | 10 | 92.6 ± 0.2 | 39.2 ± 0.9 |
| IRMv1 | 10 | 83.4 ± 0.5 | 58.6 ± 2.5 |
| meta-IRM (Ours) | 10 | 79.5 ± 0.6 | 73.4 ± 3.2 |
| Random | 10 | 10 | 10 |
| ERM (grayscale) | 10 | 73.2 ± 0.1 | 71.9 ± 0.5 |
| Optimal | — | 75 | 75 |
10 클래스 설정에서 meta-IRM의 OoD 정확도는 73.4%로 IRMv1(58.6%)보다 14.8%p 높다. ERM (grayscale) 참조값은 71.9%다. 5·10 클래스 모두에서 meta-IRM의 평균 정확도가 높지만, 실행 간 표준편차도 2-class 설정(0.9)보다 커진다(3.6, 3.2).
Insufficient Data
Training data가 절반(12,500)으로 줄었을 때, IRM 계열 방법들의 성능이 얼마나 유지되는지 평가한다.
Training data 감소 시 test accuracy (%). 25,000 → 12,500 per environment.
| Algorithm | \(p_e=0.1\) | \(p_e=0.2\) | \(p_e=0.9\) (OOD) |
|---|---|---|---|
| IRMv1 | 73.2 ± 1.6 | 71.7 ± 1.3 | 58.5 ± 2.5 |
| V-REx | 75.0 ± 0.8 | 73.4 ± 0.6 | 61.3 ± 1.4 |
| meta-IRM (Ours) | 70.6 ± 1.5 | 70.5 ± 1.6 | 68.3 ± 2.3 |
| Optimal | 75 | 75 | 75 |
데이터가 절반으로 줄었을 때, IRMv1은 66.9% → 58.5%로 8.4%p 하락하는 반면, meta-IRM은 70.4% → 68.3%로 2.1%p 하락한다. 이 설정에서는 meta-IRM이 데이터 감소에 따른 OoD 성능 저하를 더 잘 견딘다.
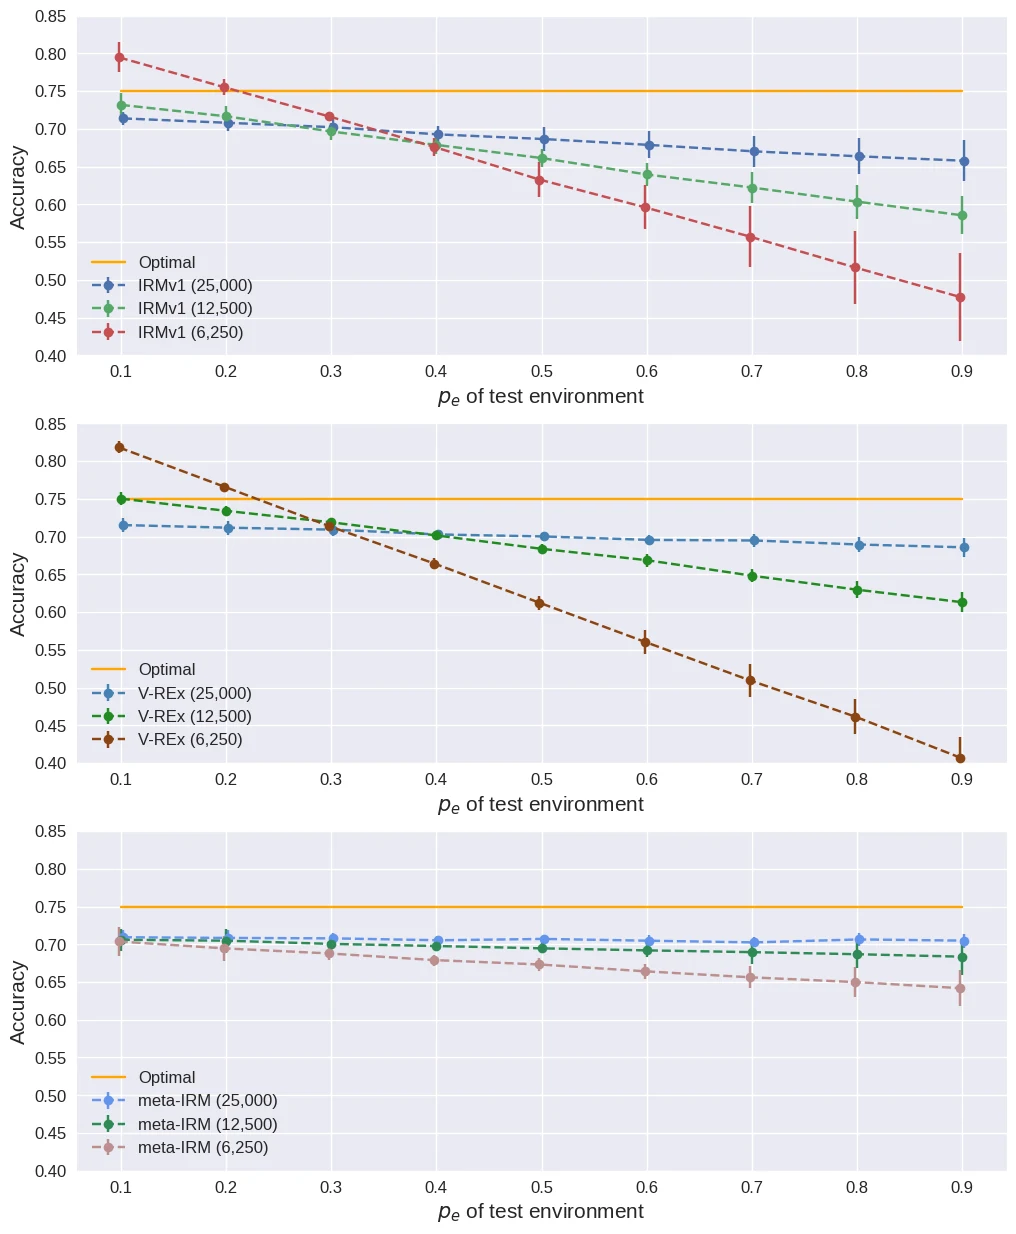
Training data 감소에 따른 영향 (25,000 → 12,500 → 6,250). 위부터 IRMv1, V-REx, meta-IRM. 데이터가 줄수록 IRMv1과 V-REx는 ERM처럼 $p_e$가 커질수록 정확도가 급락하지만, meta-IRM은 거의 평탄하게 유지된다.
Two Spurious Features
Spurious correlation이 2개(color + patch)이고 training environment도 2개인 경우다. IRMv1의 이론적 보장은 environment 수가 spurious feature 수보다 많을 때에만 성립하므로, 둘이 같은 이 설정에서는 성립하지 않는다.
| Algorithm | \(p_e=0.1\) | \(p_e=0.2\) | \(p_e=0.9\) (OOD) |
|---|---|---|---|
| IRMv1 | 93.5 ± 0.2 | 86.4 ± 0.3 | 13.4 ± 0.3 |
| V-REx | 93.6 ± 0.4 | 86.3 ± 0.3 | 13.5 ± 0.3 |
| meta-IRM (Ours) | 58.1 ± 3.1 | 56.8 ± 2.9 | 54.5 ± 4.0 |
| Optimal | 75 | 75 | 75 |
IRMv1과 V-REx는 학습 환경과 같은 상관관계에서는 정확도가 높지만, 두 상관관계가 역전된 OoD 환경에서는 13.4–13.5%로 떨어진다. meta-IRM은 54.5 ± 4.0%로 이 실패를 완화한다. 다만 평균이 랜덤 기준(50%)보다 조금 높은 수준이고 이상적 정확도(75%)와도 차이가 커, 복수 편향 문제를 해결했다고 보기는 어렵다.
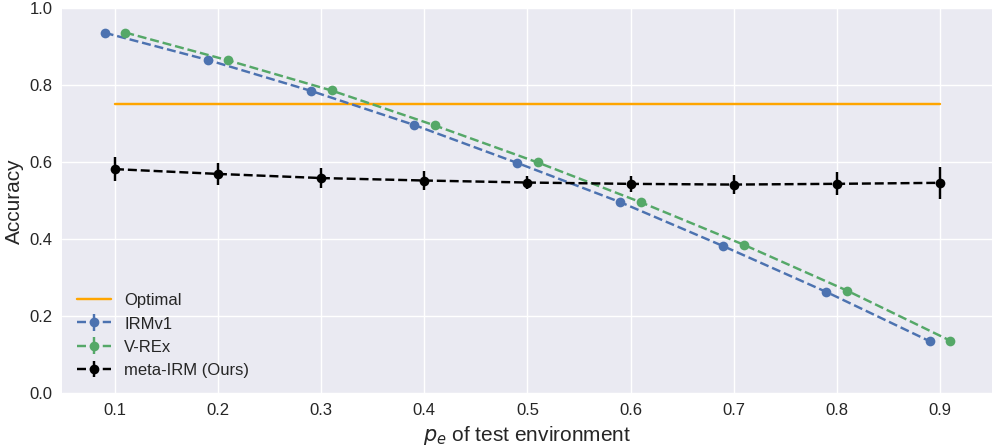
두 가지 spurious feature (color + patch) 존재 시 각 알고리즘의 test environment별 정확도.
PunctuatedSST-2 (NLP)
Colored MNIST에서 확인한 효과가 자연어 처리에서도 나타나는지를 PunctuatedSST-2로 검증한다. 감정 분석 태스크에서 구두점("!" vs “.")이 spurious feature로 작용하는 설정이다.
PunctuatedSST-2 test accuracy (%). $\eta_e$는 label noise 비율.
| Algorithm | \(\eta_e\) | Test (OOD) |
|---|---|---|
| ERM | 0.25 | 30.7 ± 1.5 |
| IRMv1 | 0.25 | 62.0 ± 1.9 |
| meta-IRM (Ours) | 0.25 | 62.2 ± 1.8 |
| ERM (vanilla) | 0.25 | 62.3 ± 0.5 |
| Optimal | 0.25 | 75 |
| ERM | 0 | 56.2 ± 2.9 |
| IRMv1 | 0 | 67.4 ± 1.4 |
| meta-IRM (Ours) | 0 | 73.0 ± 0.7 |
| ERM (vanilla) | 0 | 76.7 ± 2.7 |
| Optimal | 0 | 100 |
Label noise가 없는 설정(\(\eta_e=0\))에서 meta-IRM(73.0%)은 IRMv1(67.4%)을 5.6%p 상회하며, 구두점 spurious feature가 없는 vanilla SST-2에서 학습한 ERM (vanilla) 참조값(76.7%)에 근접한다. Label noise가 있는 경우(\(\eta_e=0.25\))에는 meta-IRM(62.2%)과 IRMv1(62.0%) 모두 구두점 없는 SST-2로 학습한 ERM (vanilla, 62.3%) 수준에 도달해, 이 설정에서는 두 방법의 차이가 거의 없다.
Ablation Study
| Variant | \(p_e=0.1\) | \(p_e=0.9\) (OOD) |
|---|---|---|
| w/o std. loss | 73.0 ± 0.8 | 64.2 ± 3.2 |
| First-order approx. | 62.6 ± 5.5 | 59.1 ± 6.3 |
| Same env. (inner = meta) | 89.3 ± 1.6 | 13.6 ± 6.6 |
| meta-IRM (Full) | 70.9 ± 0.9 | 70.4 ± 0.9 |
| Optimal | 75 | 75 |
Same environment(inner = meta) 변형은 13.6%로 ERM 수준의 실패를 보인다. Inner loop와 outer loop에 서로 다른 environment를 배정하는 것이 meta-IRM의 핵심 메커니즘임을 보여주는 결과다. First-order approximation은 second-order gradient 정보의 손실로 인해 성능과 안정성이 모두 저하된다(59.1 ± 6.3%). 표준편차 loss를 제거하면 OOD 성능이 6.2%p 떨어지고 실행 간 표준편차도 커진다(3.2 vs 0.9).