Jaesin Ahn, Chaehyeon Lee, Jun-Hyun Bae, Junho Yim, Heechul Jung
Kyungpook National University · LG Energy Solution
8th place out of 1,121 teams (final private leaderboard)
Abstract
Recently, machine unlearning has received considerable attention, in the context of responsible artificial intelligence and privacy regulations. This technical report introduces novel machine unlearning methods, such as stochastic re-initialization, knowledge preserving loss, Gaussian noise, and forget-remember cycle. We present successful unlearning results, validated in the NeurIPS 2023 Machine Unlearning Challenge, accompanied by visualizations of logit distributions and several interim experiments.
Overview
NeurIPS 2023 Machine Unlearning Challenge에 제출한 방법이다. 모델의 일부 레이어를 무작위로 초기화한 뒤, 남겨야 할 데이터(retain set)에서 원본 모델의 출력을 재현하도록 학습한다. 이 과정을 3–4회 반복하며, 최종 알고리즘은 지울 데이터(forget set)를 사용하지 않는다.
중간 실험에서는 forget set의 gradient를 이용한 FIM 기반 선택보다 무작위 초기화가 높은 점수를 얻었다. 대회는 512회 실행의 출력 분포를 재학습 모델의 분포와 비교했기 때문에, 실행마다 달라지는 초기화 위치도 평가에 영향을 줄 수 있었다. 또 한 번에 초기화 비율을 높이는 것보다, retain set 학습을 사이에 두고 여러 번 초기화하는 방식의 점수가 높았다.

전체 아키텍처. (a) Retain set 이미지에 Gaussian noise 추가, (b) 무작위로 선택한 레이어를 재초기화(stochastic re-initialization), (c) 원본 모델과의 knowledge preserving loss 계산, (d) (a)–(c)를 $n$ cycle 반복.
Challenge
대회 과제는 비공개 얼굴 나이 추정 데이터셋(32×32 이미지 약 30,000장)으로 학습된 ResNet-18에서, 15명의 이미지로 이루어진 forget set의 영향을 지우는 것이다. 나머지 학습 데이터는 retain set이며, unlearning이 성공했다면 모델은 forget set 없이 처음부터 다시 학습한 모델(retrained model)과 구별되지 않아야 한다. 제출한 알고리즘은 서로 독립된 512회 실행을 8시간 안에 마쳐야 한다.
대회의 평가 메트릭은 단순한 정확도가 아닌 분포 기반 unlearning quality로, 다음과 같이 정의된다:
\[\text{Score} = F \times \frac{RA_U}{RA_R} \times \frac{TA_U}{TA_R}\]\(F\)는 forgetting quality, \(RA_U / RA_R\)은 retain accuracy 비율(unlearned vs retrained), \(TA_U / TA_R\)은 test accuracy 비율이다. \(F\)는 512회 독립 실행의 출력 분포를 재학습 모델의 분포와 비교해 계산한다. 따라서 retain/test 정확도가 같아도 실행 간 출력 분포가 다르면 점수가 달라질 수 있다.
Method
Stochastic Re-initialization
모델의 일부 레이어를 랜덤으로 선택하여 re-initialize한 뒤 retain set으로 fine-tune한다. Forget set의 gradient로 계산한 Fisher information matrix(FIM)의 대각 성분을 기준으로 재초기화할 파라미터를 고르는 방식이 직관적으로는 합리적이지만, 실제로는 점수가 더 낮았다. FIM 기반 선택은 매 실행마다 같은 파라미터를 고르므로 512회 실행의 출력 분포가 좁아져, retrained model의 분포와 잘 겹치지 않는 것으로 추정된다. 랜덤 선택은 이 다양성을 자연스럽게 확보한다.
FC layer와 projection-shortcut layer는 클래스/해상도 정보를 담고 있어 re-initialization 대상에서 제외한다.
Knowledge Preserving Loss
Retain set에 대해서는 원본 모델의 출력을 재현하도록 MSE loss로 학습한다:
\[\mathcal{L}_{KP} = \mathbb{E}\left[|f_O(\mathbf{I}'_R) - f_U(\mathbf{I}'_R)|^2\right]\]Cross-entropy(0.0653)나 L1 loss(0.0326)보다 MSE loss(0.0680)가 가장 높은 점수를 기록한다.
Gaussian Noise Augmentation
Retain set 이미지에 Gaussian noise를 추가하여 randomness를 확보하면서도 robust한 knowledge preserving 효과를 얻는다. Ablation에서는 \(\sigma=0.1\)이 최적(\(0.06532\))이며, \(\sigma=0.05\)(\(0.06333\)) 및 \(\sigma=0.15\)(\(0.05907\))보다 우수하다. Vertical flip(\(0.02505\)), random crop/cutout(\(0.00001\))은 점수가 급락하는 반면, Gaussian noise는 소폭의 개선을 가져온다. 최종 제출한 두 알고리즘은 \(\sigma=0.01\)을 사용한다.
Forget-Remember Cycles
Re-initialization 비율을 단순히 높이면 모델이 과도하게 망각한다. 단일 cycle에서 비율을 10% → 20%로 늘리면 오히려 점수가 하락한다(0.0680 → 0.0656). 대신 3–4 cycle로 forgetting과 remembering을 반복하면, 총 re-initialization 비율을 점진적으로 높이면서도 retain set 성능을 유지할 수 있다. 이 cycle 구조가 가장 큰 성능 향상을 가져온 요소로, 점수는 단일 cycle(0.0680)에서 2 cycle(0.0844)로 크게 오르고, 3 cycle(0.0856)에서 소폭 더 오른다.
알고리즘 하이퍼파라미터. 1st 알고리즘은 3 cycles [1, 2, 2] epochs에 cosine learning rate scheduler(\(init\_lr=0.001\), \(T\_max=2\))를 사용한다. 2nd 알고리즘은 4 cycles [2, 1, 1, 1] epochs에 epoch별 학습률 [0.0005, 0.001, 0.001, 0.001, 0.001]을 사용한다. 두 알고리즘 모두 선택 풀에서 6개 레이어를 복원 추출(with replacement)한다. Gaussian noise는 평균 0, 표준편차 0.01의 분포에서 샘플링한다.
Results
Quantitative
아래 점수는 대회 public leaderboard 기준이며, Fine-tune은 주최 측이 제공한 starter code다.
| Model | Score |
|---|---|
| Negrad | 0.0001 (±0.0001) |
| Fine-tune (baseline) | 0.0464 (±0.0031) |
| 1st Algo. (ours) | 0.0939 (±0.0065) |
| 2nd Algo. (ours) | 0.0929 (±0.0051) |
| 1st Algo. (ours, best) | 0.1020 |
| 2nd Algo. (ours, best) | 0.1024 |
Ablation Study
각 구성 요소가 최종 성능에 미치는 영향을 순차적으로 분석한다.
Re-initialization.
| 실험 | Score |
|---|---|
| Fine-tune | 0.0496 |
| + Stochastic Re-init (random) | 0.0617 |
| + FIM-based Re-init | 0.0486 |
Data Augmentation (10% Re-init, 3 ep 기준).
| Input Data | Score |
|---|---|
| Clean Image | 0.06172 |
| Vertical Flip | 0.02505 |
| Random Crop | 0.00001 |
| Cutout | 0.00001 |
| + Gaussian Noise (\(\sigma=0.05\)) | 0.06333 |
| + Gaussian Noise (\(\sigma=0.15\)) | 0.05907 |
| + Gaussian Noise (\(\sigma=0.1\)) | 0.06532 |
Loss Functions.
| Loss | Score |
|---|---|
| CE Loss | 0.0653 |
| L1 Loss | 0.0326 |
| MSE Loss | 0.0680 |
Number of Cycles.
| Cycles | Selection Ratio | Score |
|---|---|---|
| 1 (2 ep) | 10% | 0.0680 |
| 1 (2 ep) | 20% | 0.0656 |
| 2 (2-2 ep) | ~20% | 0.0844 |
| 3 (1-2-2 ep) | ~30% | 0.0856 |
Selection Pool (Layer Exclusion).
| Excluded Layers | Selection Ratio | Score |
|---|---|---|
| None | ~30% | 0.0856 |
| FC only | ~30% | 0.0926 |
| FC & Projection-shortcut | ~30% | 0.0969 |
FIM 기반 re-initialization(0.0486)은 fine-tune만 한 경우(0.0496)보다도 낮은 반면, 랜덤 선택(0.0617)은 점수를 크게 끌어올린다. 개별 요소 중에서는 cycle 구조(0.0680 → 0.0856)의 향상 폭이 가장 크고, stochastic re-initialization(0.0496 → 0.0617)과 layer 선택 풀 제한(0.0856 → 0.0969)이 뒤를 잇는다.
추가로, layer-wise 선택(0.0856)이 element-wise 선택(0.0575)보다 현저히 우수하다.
Logit Distribution
Forget set과 retain set에서의 logit 분포를 비교하면, 제안 방법이 fine-tuning보다 retrained model의 분포에 더 가깝다. 대회 데이터셋은 비공개이므로 시각화에는 MUFAC 데이터셋을 사용했다.
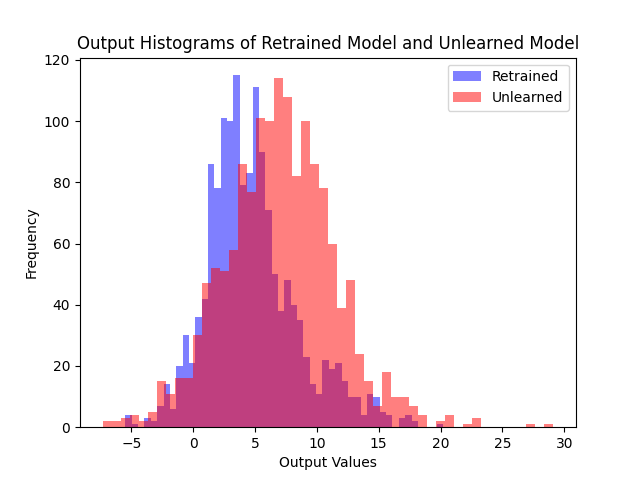
(a) Fine-tune
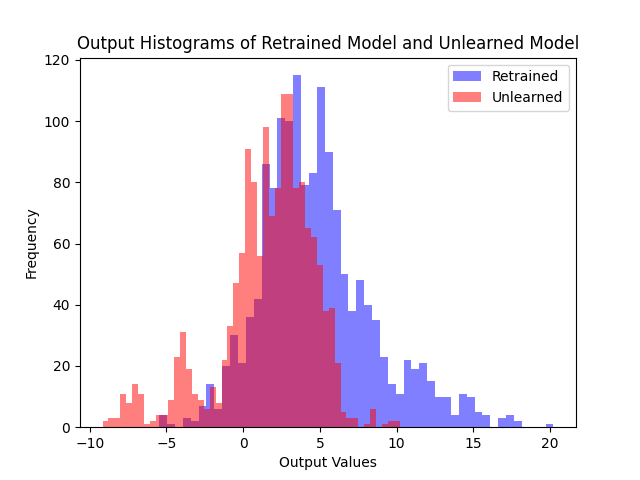
(b) 1st Algo.

(c) 2nd Algo.
Forget set의 logit 분포(MUFAC). Fine-tune은 retrained model보다 오른쪽으로 치우쳐 있는 반면, 두 제안 알고리즘은 주된 분포가 retrained model과 더 잘 겹친다.
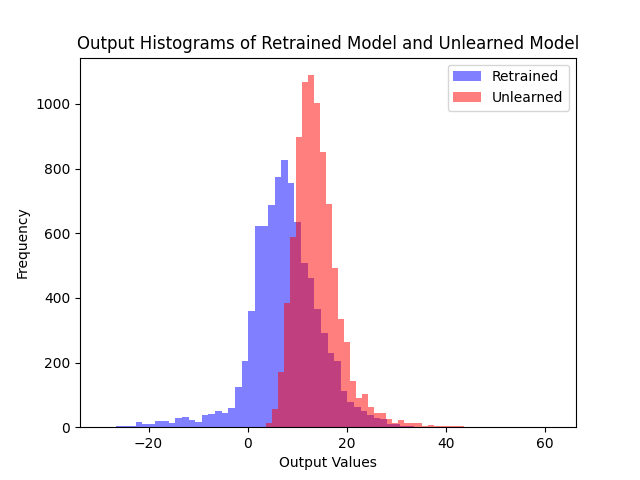
(a) Fine-tune
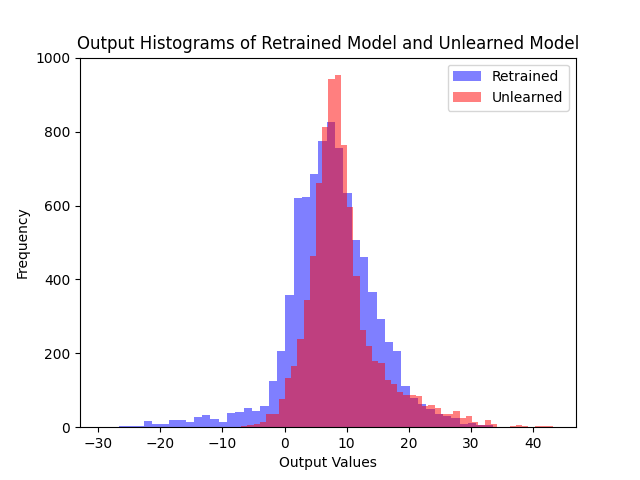
(b) 1st Algo.

(c) 2nd Algo.
Retain set의 logit 분포(MUFAC). Fine-tune은 retrained model보다 오른쪽으로 치우치지만, 두 알고리즘은 retrained model과 대부분 겹친다.